每日文章
共 23 条文章,每页 10 条。
REA:让 AI Agent 接管逆向工程,Reverse Engineer Anything
当我们想要弄懂一款闭源软件内部逻辑、搞清楚某个功能的实现原理,传统逆向工程往往门槛极高:需要熟练掌握 Ghidra、Hopper 等逆向工具,读懂汇编、伪代码,手动交叉引用函数,耗费大量人力。开源项目 REA(Reverse Engineer Anything) 的出现,把 AI 智能体与逆向工具链打通,让大模型可以直接操作二进制程序,完成从静态解析、行为追踪到功能复现的完整逆向流程,成为近期 GitHub 现象级开源项目。
阅读全文 →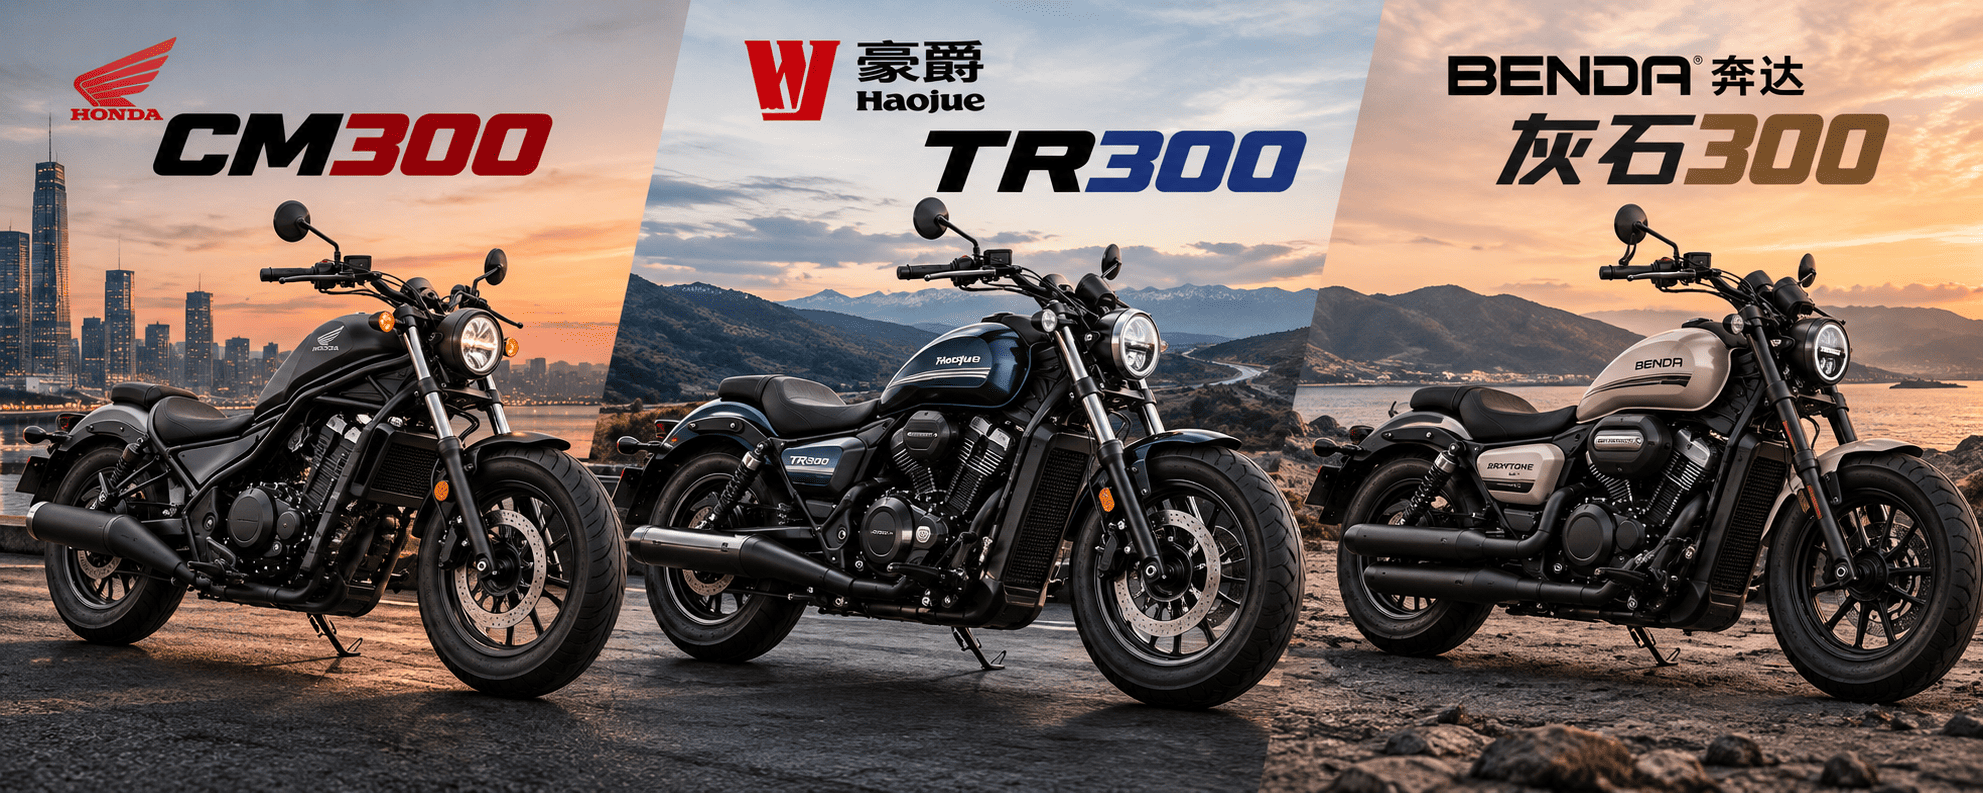
300cc 热门巡航新手选购指南:本田 CM300、豪爵 TR300、奔达灰石 300 全方位对比
对于刚拿驾照、想入手第一台巡航机车的新手来说,300cc 排量是黄金选择。这个排量兼顾动力、油耗、操控和性价比,不会过于暴躁难以掌控,也不会动力孱弱满足不了日常骑行需求。其中本田 CM300、豪爵 TR300、奔达灰石 300是目前国内市场热度最高、受众最广的三款入门巡航车,几乎覆盖了新手 90% 的购车需求。
阅读全文 →解锁 Claude 企业级生产力:深度解析 Anthropic 官方 Knowledge Work Plugins
在 AI 办公深度普及的当下,通用大模型的“通用性”逐渐成为企业落地的短板。通用对话模式无法适配不同岗位的专业流程、无法对接企业现有工具栈、输出结果参差不齐、难以贴合团队标准化工作规范。为解决这一痛点,Anthropic 官方开源了 knowledge-work-plugins 项目,一套面向岗位、团队、企业的标准化 Claude 插件体系,让 AI 从“通用聊天助手”变身“垂直岗位专属专家”,全面适配 Claude Cowork 与 Claude Code 双场景,成为企业落地 AI 办公的核心基础设施。
阅读全文 →SkillHub:面向国内用户的 AI Skill 社区,让 AI 能力可复用、可分发、可变现
在 AI Agent 快速发展的当下,大模型本身的能力边界,越来越依赖外部技能与插件进行拓展。SkillHub(skillhub.cn)就是一个专为国内用户优化的 AI Skills 开源社区,如同 AI 智能体的 “应用商店”,目标是让专业能力被使用、被复用、被变现,打通技能的开发、审核、分发、商业化完整链路SkillHub。
阅读全文 →
Awesome‑LLM‑Apps:百套可直接运行的 LLM 应用模板,告别重复造轮子
当大模型 API 唾手可得,很多开发者却卡在同一个困境:概念看得懂,但动手做 Agent、RAG、多智能体应用时,需要反复搭建脚手架、调试工具调用、处理链路异常。大量开源仓库只是资料清单,示例代码残缺不全,很难真正跑通。Awesome‑LLM‑Apps正是为解决这个痛点而生:它不是简单的资源合集,而是一套亲手开发、端到端测试完成,超过 100 套开箱即用的大模型应用模板库,Apache‑2.0 开源协议允许自由克隆、二次改造,甚至商用发布GitHub。
阅读全文 →
OpenMAIC:用多智能体重构在线课堂,把任意文档变成沉浸式 AI 教学体验
当传统网课还停留在录播视频、静态 PPT 单向输出的时代,清华大学 THU‑MAIC 团队开源的OpenMAIC(Open Multi‑Agent Interactive Classroom,开放式多智能体交互式课堂),给出了 AI 原生教育的全新解法:输入一段描述、一份 PDF 文档,几分钟之内就能生成一整套完整、可交互、具备完整课堂氛围的虚拟课堂环境CSDN博...
阅读全文 →
Crawl4AI:面向大模型时代的开源网页爬虫工具
Crawl4AI正是为解决这一痛点而生的开源网页爬取与数据提取框架,它主打「LLM 友好」,可以把网页转化为干净可用的 Markdown,适配 AI 数据管道,如今已经成为 GitHub 热度最高的爬虫开源项目之一,收获七万多 Star,被全球五万多名开发者使用CSDN。
阅读全文 →
Skill Recorder:微软开源,录一遍操作,让 AI Agent 学会你的工作流程
它不是普通录屏软件,也不等同传统 RPA。RPA 是记录鼠标坐标、像素界面,机械回放点击,页面改版就直接失效;Skill Recorder 不回放 UI 点击,而是抽象出任务意图与业务步骤,优先调用 Agent 原生工具(gh、web_fetch等)完成任务,具备泛化能力,录制一次表单提交,AI 可以举一反三处理同类表单场景CSDN博...。
阅读全文 →
WorkBuddy 与 CodeBuddy 怎么选?同源 AI 工具,定位完全不一样
很多人第一次接触腾讯云这两款 AI 工具,很容易被相近的名字搞混淆。二者底层大模型同源、账号积分互通,但服务场景、目标人群、产品形态截然不同,一个主打办公自动化,一个专注 AI 编程开发CSDN博
阅读全文 →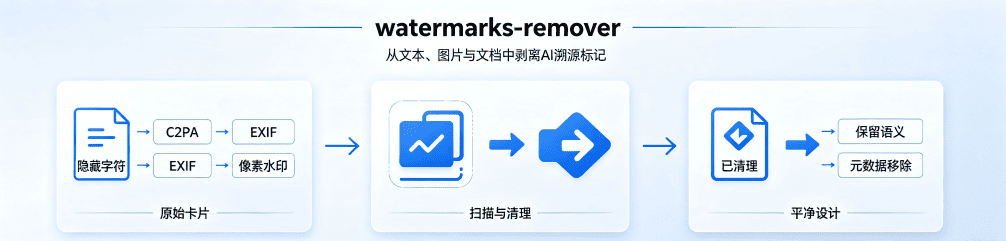
watermarks‑remover:开源 AI 溯源水印剥离工具,一场 AI 水印的攻防实践
当 Claude、Gemini、OpenAI 等大模型纷纷上线 AI 内容溯源水印机制,用于标记 AI 生成文本、图片来源,一套名为watermarks‑remover的开源 Python 项目迅速走红 GitHub。它不是面向盗版破解的黑盒工具,而是面向内容所有者,用于清理自己产出内容中 AI 厂商嵌入的各类溯源标记,兼顾隐私保护与内容清洗,同时毫不回避技术本身的局限性与伦理边界。
阅读全文 →